汉王PDF OCR中文版是一款非常优秀的文字识别软件,该软件内置了多种的输出格式和表格识别功能,方便了用户的阅读和编辑。此外,识别速度快,用户无需等待太长时间哦。并且,支持BMP、TIF、JPG、PDF多种格式,无需担心不兼容的情况发生了。同时,能够一键批量进行处理,大大的提高了效率还可以节省不必要的麻烦。值得一提的是,今天我给大家带来的是“汉王PDF OCR免安装版”,该版本是免安装的,打开就可以使用哦。不仅如此,还可以保留原始版面格式,例如:表格、段落等等,让识别后的文档结构清晰。除此之外,里面的字体、字号、页面布局等等参数都是可以进行调整的,满足不同人群的需求。觉得这款软件不错的小伙伴们还在等什么,心动不如行动,快来下载体验吧!
软件功能
软件具有识别正确率高,识别速度快的特点。
支持批量处理功能,避免了单页处理的麻烦。
支持处理灰度、彩色、黑白三种色彩图像文件;
可识别简体、繁体和英文三种语言;
具有简单易用的表格识别功能;
具有TXT、RTF、HTM和XLS多种输出格式,并有所见即所得的版面还原功能。
软件亮点
1.图像输入、图像前处理、预识别。
2.图像输入
对于不同的图像格式,有着不同的存储格式,不同的压缩方式,目前有OpenCV、CxImage等开源项目。
3.预处理
软件功能主要包括二值化,噪声去除,倾斜较正等。
4.二值化
对摄像头拍摄的图片,大多数是彩色图像,彩色图像所含信息量巨大,对于图片的内容,可以简单的分为前景与背景,为了让计算机更快的、更好地识别文字,我们需要先对彩色图进行处理,使图片只前景信息与背景信息,可以简单的定义前景信息为黑色,背景信息为白色,这就是二值化图。
5.噪声去除
对于不同的文档,对噪声的定义可以不同,根据噪声的特征进行去燥,就叫做噪声去除。
6.倾斜校正
由于一般用户,在拍照文档时,都比较随意,因此拍照出来的图片不可避免的产生倾斜,这就需要文字识别软件进行较正。
7.版面分析
软件可以将文档图片分段落,分行的过程就叫做版面分析,由于实际文档的多样性,复杂性,因此,目前还没有一个固定的,最优的切割模型。
8.字符切割
由于拍照条件的限制,经常造成字符粘连,断笔,因此极大限制了识别系统的性能。
9.字符识别
这一研究已经是很早的事情了,比较早有模板匹配,后来以特征提取为主,由于文字的位移,笔画的粗细,断笔,粘连,旋转等因素的影响,极大影响特征的提取的难度。
10.版面还原
人们希望识别后的文字,仍然像原文档图片那样排列着,段落不变,位置不变,顺序不变地输出到Word文档、PDF文档等,这一过程就叫做版面还原。
安装教程
1、双击从本站下载的安装包,打开安装向导,单击【下一步】。
2、同意许可证协议,单击【是】。
3、单击【浏览】选择软件安装位置,单击【下一步】。
4、耐心等待一下软件安装。
5、安装完成,单击【完成】就可以使用软件了。
汉王PDF OCR官方版使用教程
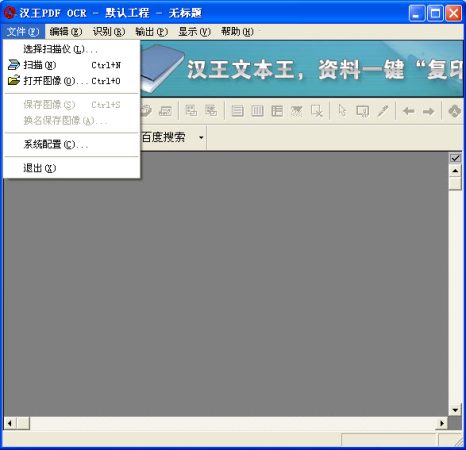
1、在主界面任务栏左上角【文件】选项中选择打开图像,快捷键Ctrl+O。
2、查找您需要转换的pdf文件,注意:不需要点打开,你只需要选中就行,然后点击【pdf转换为TXT文件】。
3、选择你需要转换的页面,也就是你pdf文件里边的内容你需要转换的部分,默认是全部转换。然后选择转换后txt文版的保存地址,点击【浏览】选择文件夹。
4、转换完成,时间根据内容的多少来确定。
更新日志
将bug扫地出门进行到底
优化用户反馈的问题,提升细节体验