千百OCR官方版是一款非常强大的ocr识别工具,该软件内置识别次数统计,帮助用户跟踪使用情况。此外,支持JPG、PNG、BMP、TIF等等格式,无需担心不兼容的情况发生了。并且,添加了批量识别功能,可一次性处理多张图片或PDF文件,大大的提高了效率哦。当然,识别速度快。大图片也能实现秒级识别。同时,可以截屏进行识别,十分方便哦。值得一提的是,今天我给大家带来的是“千百OCR中文版”,该版本就不用为语言不通而忧愁了。不仅如此,这款软件还采用了SSL 加密传输保护数据,用户无需担心信息泄露的情况发生了。对这款软件感兴趣的小伙伴们还在等什么,心动不如行动,快来下载体验吧!
软件功能
多语言支持:
支持中文简体、繁体、英文、日文、韩文、俄文、意大利语、法语、德语、葡萄牙语和西班牙语等28种语言的文字识别。
提供文言文和粤语的特色翻译功能,满足多样化需求。
用户友好设计:
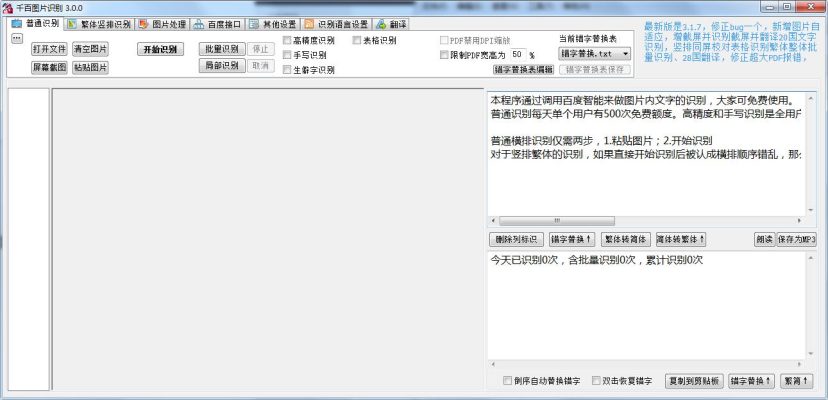
简洁界面:操作流程直观,仅需两步即可完成识别(打开图片/PDF→点击识别)。
一键操作:支持繁简转换、错字替换及倒序粘贴等快捷功能,提升编辑效率。
兼容性与稳定性:
软件体积小巧,安装包仅4MB左右,运行流畅且资源占用低。
定期更新优化兼容性,支持Windows各版本系统,包括老旧系统如Windows XP。
软件亮点
多格式支持:
支持从屏幕截图、图片文件以及PDF文件中直接提取文字内容。
可识别CAJ格式文件,满足学术研究需求。
高效识别能力:
快速识别:大图片也能实现秒级识别,显著提升工作效率。
高精度识别:提供高精度识别模式,确保符号、数字及复杂排版内容的准确提取。
软件优势
特殊场景优化:
繁体竖排识别:针对古籍、竖排繁体文本进行专项优化,支持自动打标、标线调整及同屏校对,确保识别结果准确无误。
低质量图片识别:可识别早期扫描版PDF、模糊图片或古籍古书中的文字,解决传统OCR工具的识别难题。
格式转换与编辑:
PDF转图片:将PDF整书按比例缩放后转换为每页一张JPG图片,便于后续处理。
文字编辑:识别后的文字可直接复制到编辑框中,支持符号、数字及格式保留,方便后续修改或排版。
安装教程
1.下载安装包,解压后,双击exe程序,进入安装向导,单击下一步
2.点击“浏览”选择安装文件夹,一般默认安装在电脑C盘,推荐安装在D盘,单击下一步
3.点击“浏览”选择开始菜单文件夹,单击下一步
4.选择附加任务,勾选创建桌面快捷方式,单击下一步
5.安装程序准备完毕,单击安装
6.软件正在安装,请耐心等待
7.安装完成,单击完成退出安装向导
千百OCR电脑版使用教程
1.打开图片,或者点击“屏幕截图”按钮在屏幕上截图。或者使用QQ截图之类的截图后点击“粘贴图片”按钮。截屏快捷键 CTRL + ALT + D 用该快捷键截屏后会自动粘贴图片。
2.点击“开始识别”按钮,然后等待识别结果。
对于竖排的繁体字,如果列宽比较宽的,可以直接点“开始识别”按钮进行识别。